CC攻击绕过CDN防护的常见方法与技术思路

在网络安全攻防博弈的持续演进过程中,CDN(内容分发网络)早已成为各类网站抵御分布式拒绝服务攻击、保障访问稳定性的核心基础设施,尤其针对常见的CC(Challenge Collapsar)攻击,CDN厂商普遍部署了频率限制、特征识别、人机验证、行为分析等多层防护机制,试图从海量请求中精准筛选并拦截恶意流量,然而随着攻击手段的迭代升级,攻击者也在不断索绕过CDN CC防护的各类路径,这场围绕流量合法性的对抗,始终在技术升级与策略突破的双向拉扯中不断升级。
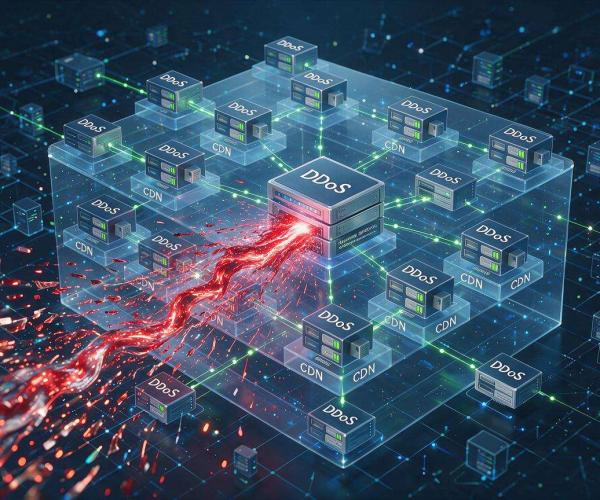
要理解CC攻击绕过CDN防护的逻辑,首先需要厘清CDN防御CC攻击的核心机制。传统CDN的CC防护大多基于“异常特征匹配”和“访问行为建模”两大体系:特征匹配层面会识别请求头中的User-Agent异常、Cookie缺失、请求路径固定、来源IP集中等显性特征,一旦命中规则就会直接拦截;行为建模层面则会基于单IP的请求频率、访问间隔的规律性、请求资源的分布特征、会话建立的完整性等维度构建正常用户的行为基线,偏离基线过多的请求就会触发滑块验证、短信验证等人机校验环节,严重时直接封禁IP。这些防护机制在应对早期工具化、模板化的CC攻击时效果显著,但也存在自身的局限性,而这些局限性恰恰成为攻击者寻找绕过路径的突破口。
当下常见的绕过思路中,基于“流量特征伪装”的手段是最基础也最普遍的。攻击者会放弃传统的固定请求模板,转而通过模拟真实用户的完整访问链路来规避特征检测:比如先访问网站首页获取正常的Cookie和Session标识,再按照页面内的链接顺序依次访问图片、样式表、接口等资源,请求的User-Agent会从主流浏览器的UA库中随机选取,Referer字段也会对应真实的页面跳转来源,甚至会模拟不同浏览器的指纹特征,包括字体列表、插件配置、画布指纹等,让单条请求的特征与真实用户几乎没有差异。与此攻击者还会利用大量代理IP资源打散请求来源,比如通过住宅代理、移动代理池获取不同地区、不同运营商的真实用户IP,避免单IP请求频率过高触发封禁,每个IP的请求频率会被控制在CDN防护阈值以下,通过“低频率+广分布”的模式累积攻击流量,让CDN的IP限流机制难以发挥作用。
更进阶的绕过手段则会针对CDN的防护逻辑缺陷进行精准打击。比如部分CDN的防护规则存在“静态资源豁免”的设定,即认为静态资源的请求大多是正常的,不会对其施加严格的频率限制,攻击者就会将攻击目标指向网站的静态资源接口,或者构造带有静态资源后缀的动态请求,利用路由规则的匹配漏洞绕过分频检测。还有部分CDN的防护节点存在地域差异,不同区域的防护策略严格程度不同,攻击者会通过探测找到防护较弱的边缘节点,将攻击流量集中导向这些节点,实现局部过载。针对CDN的人机验证环节,攻击者也发展出了多种破解方式:一方面可以利用机器学习训练验证码识别模型,自动完成滑块、点选、图形验证码的校验;另一方面则可以通过调用真实设备的操作环境,比如利用云手机、群控系统模拟真人的滑动轨迹和点击行为,甚至接入打码平台的人工服务,直接绕过人机验证的关卡。
还有一类更具隐蔽性的绕过方式,是从CDN的“身份认知”层面入手,也就是找到网站的真实源站IP,直接将攻击流量绕过CDN节点打向源站服务器。获取真实源站IP的方法多种多样:比如通过历史DNS记录查询,找到网站接入CDN之前的IP地址;通过发送带有特定标识的邮件,让网站服务器主动回连时暴露真实IP;通过扫描全网IP的证书信息,匹配与目标网站一致的SSL证书来定位源站;甚至可以利用网站的特殊功能接口,比如头像上传、远程文件获取等功能,让源站主动发起对外请求从而泄露IP。一旦拿到真实源站地址,攻击者就可以避开CDN的所有防护机制,直接对源站发动CC攻击,这种方式往往防御难度更高,造成的危害也更大。
需要明确的是,所有关于CC攻击绕过CDN防护的技术探讨,本质上都是为了帮助防御方更清晰地认知攻击路径,从而构建更完善的防护体系。对于网站运营方而言,不能仅仅依赖CDN的默认防护策略,而需要结合自身业务特征定制防护规则:比如针对不同业务接口设置差异化的频率阈值,引入更精准的用户行为画像模型,加强对源站IP的隐藏防护,定期排查可能泄露源站的风险点,同时在CDN之外部署多层级的防护架构,比如源站端的WAF、流量清洗设备等,形成纵深防御体系。网络安全的对抗从来不是单方面的一劳永逸,只有持续跟踪攻击手段的演变,不断迭代防护策略,才能在攻防博弈中占据主动,保障业务的稳定运行。